在本科的课程中曾有做 CIFAR-10 和 CIFAR-100 任务的课程作业,在当时也接触和了解了 ResNet 和 ViT 这些经典的视觉模型和算法。现在也借着做周报的机会,想着能以此为开端,系统性地阅读和学习多模态领域的文献,暂时以类似笔记的博客形式来记录。
这份笔记依次涉及 ResNet、ViT,并进一步拓展到 CLIP。前两篇主要讨论图像如何被编码成有效的特征,后一篇进一步改变了训练这些特征的监督方式,以及它们在下游任务中的使用方式。
这里有两条线索:一条是视觉骨干的结构,从卷积与残差连接,到以图像块为输入的 Transformer;另一条是表征的学习目标,从图像分类的类别监督,到图像与自然语言之间的配对关系。
1. ResNet:用残差形式组织深层网络
ResNet 的出发点是深层网络的退化现象:增加网络层数后,训练误差反而可能上升。这里需要注意,训练集上的误差也变差,不能仅用过拟合来解释;论文讨论的是深层网络的优化困难。§1–3
从表达能力看,可以设想把一个浅层网络的参数复制到更深的网络中,再让新增层实现恒等映射。这样深层网络至少能够表示浅层网络已有的函数。但普通的多层非线性变换并不容易通过优化得到恒等映射,这也是论文引入残差形式的直观依据。
残差学习把目标映射 $H(x)$ 改写为:
$$ H(x) = F(x) + x. $$网络中的可学习分支拟合 $F(x)=H(x)-x$,捷径分支传递输入。当目标映射接近恒等映射时,可学习分支只需要拟合一个较小的修正量。若输入、输出维度不同,则使用投影等方式匹配维度。上式概括了相加处的关系;原始残差块在相加后一般还有激活。
原论文还区分了基本残差块和用于更深网络的 bottleneck:后者通过 $1\times1$、$3\times3$、$1\times1$ 卷积先减少通道数、进行空间变换,再增加通道数,在加深网络时控制计算开销。§3.3、§4.1
这种结构可以给信息和梯度的传递提供更加直接的路径。
联系之前的图像分类任务,可以把网络分成视觉骨干与分类头:骨干产生特征,分类头把特征映射为固定类别的分数。残差结构主要改善骨干的构造与训练,并没有规定特征只能用于分类。这一点也可以联系到 CLIP 对 ResNet 的使用。
2. ViT:把图像切块并表示为 token 序列
ViT 的主要想法是把 NLP 的成熟方法搬过来,让自注意力机制能在视觉领域发挥作用。
一般来说直接把所有像素点的信息喂给 Transformer 的话,开销过大。 ViT 将图像划分为固定大小的 patch,对每个 patch 展平并做线性投影,再加入位置嵌入与可学习的分类 token,交给 Transformer encoder。原论文采用分类 token 的最终表示接分类头。§3
这里的 token 是一个图像块的向量表示,并不具有词语那样预先确定的语义。若图像有 $C$ 个通道,每个展平的 patch 有 $P^2C$ 个数,再由同一个可学习投影映射到维度 $D$。位置嵌入补充空间位置信息;分类 token 则在多层信息交换中汇集用于分类的表示。
对于大小为 $H\times W$ 的图像和边长为 $P$ 的 patch,图像块数为:
$$ N = \frac{HW}{P^2}. $$若两边均能被 $P$ 整除,输入序列长度为 $N+1$,其中额外的一个 token 是 cls token。例如,$224\times224$ 的图像以 $16\times16$ 分块时得到 $196$ 个 patch,加上 cls 后长度为 $197$。
分块大小同时影响表示与计算。边长 $P$ 减半时,patch 数量变为原来的四倍,标准自注意力矩阵的元素数约增加到十六倍。更细的空间划分同时带来了更长的序列。
与卷积显式引入局部性和空间上的权重共享相比,ViT 在架构中保留的图像相关的归纳偏置较少,patch 之间通过自注意力交换信息。卷积层的局部邻域由结构预先规定;自注意力则根据当前输入计算 token 之间的权重,在一层中就可以建立远距离的信息联系。
论文通过不同预训练数据规模来讨论这种差别:在较小的数据规模下,ViT 不一定胜过 ResNet;大规模预训练后,ViT 的迁移表现更有优势。§4.3–4.4
ViT 的经典 Transformer block 同样使用残差连接:注意力负责 token 之间的信息交换,MLP 变换每个 token 的表示,残差分支连接变换前后的表示。
读到这里,可以把 ResNet 和 ViT 都看作视觉特征提取器的不同实现。
3. CLIP:用图文配对关系学习表征
CLIP(Contrastive Language–Image Pre-training)联合训练图像编码器和文本编码器,将两种输入映射到可以比较的向量空间。
在常规的类别监督中,一张图像对应一个预先定义的类别标签;自然语言可以提供更开放的描述,涉及对象、属性、动作或场景。CLIP 的主要工作就是使用包含约 4 亿对图文的 WIT 数据集,通过互联网已有的图文关联扩展监督来源。它不再需要为预训练中的所有概念先建立一套固定分类表。§2.1
CLIP 的核心在于将配对关系作为训练信号,使得文本在推理时成为描述类别的接口。相对地,对视觉骨干的选择和使用就很自由。
3.1 两个编码器与相似度矩阵
原论文使用的图像编码器包括修改后的 ResNet 和 ViT,文本编码器采用 Transformer;这些编码器从头训练。其中,ResNet 的全局平均池化被替换为注意力池化,ViT 也有较小的结构调整。§2.2–2.4
图像编码器输出整张图像的表示;文本编码器使用结束标记所在位置的最终特征,然后形成一个相似度矩阵。
设一个批次包含 $N$ 对图文样本 $(I_i,T_i)$。编码、投影并归一化后,图像向量与文本向量分别记为 $\mathbf u_i$ 和 $\mathbf v_i$:
$$ \mathbf u_i = \frac{W_I f_I(I_i)}{\lVert W_I f_I(I_i)\rVert_2}, \qquad \mathbf v_i = \frac{W_T f_T(T_i)}{\lVert W_T f_T(T_i)\rVert_2}. $$这里采用列向量记法。$f_I$、$f_T$ 是编码器,$W_I$、$W_T$ 是各自的线性投影。两侧原始特征可以有不同维度,但投影后需要处于同一维度。
归一化以后,向量的内积就是余弦相似度。对一个批次内的所有组合计算:
$$ S_{ij} = \frac{\mathbf u_i^\top \mathbf v_j}{\tau}. $$$S$ 是 $N\times N$ 的矩阵。对于第 $i$ 张图像,第 $i$ 段文本是批次中的配对文本,目标位置在对角线上。这里共有 $N$ 个正配对和 $N(N-1)$ 个非配对组合,后者直接来自同一个批次,不需要再为每个正配对单独组织一套负样本。
3.2 对比目标
逐行归一化时,是给定图像、在批次文本中寻找它的配对文本:
$$ \mathcal L_{I\to T} =-\frac{1}{N}\sum_{i=1}^{N} \log \frac{\exp(S_{ii})}{\sum_{j=1}^{N}\exp(S_{ij})}. $$逐列归一化时,是给定文本、在批次图像中寻找它的配对图像:
$$ \mathcal L_{T\to I} =-\frac{1}{N}\sum_{i=1}^{N} \log \frac{\exp(S_{ii})}{\sum_{j=1}^{N}\exp(S_{ji})}. $$最终损失取两者的平均:$\mathcal L=(\mathcal L_{I\to T}+\mathcal L_{T\to I})/2$。这两个方向共用同一个相似度矩阵,只是 softmax 的归一化方向不同。逐行强调一张图像能够找到正确文本,逐列强调一段文本能够找到正确图像。§2.2、图 3
对于一行的损失 $\ell_i=-\log p_{ii}$,可以直接求得:
$$ \frac{\partial\ell_i}{\partial S_{ij}} =p_{ij}-\mathbf 1[j=i]. $$这里 $p_{ij}$ 是该行的 softmax 概率。这也说明,分数较高的错误候选会带来更大的梯度压力,目标并非把所有非配对组合以相同力度推开。
下面简单用伪代码展示损失的计算关系。
# u、v: [batch_size, embedding_dim],同一行来自同一对图文
scores = logit_scale.exp() * (u @ v.T)
pair_index = torch.arange(len(u), device=u.device)
image_loss = F.cross_entropy(scores, pair_index)
text_loss = F.cross_entropy(scores.T, pair_index)
loss = 0.5 * (image_loss + text_loss)
模型学习本质上的是内容之间的匹配规则。
批次大小也会影响这个目标:每张图像同时与 $N-1$ 段非配对文本竞争,批次变大时,候选数量与候选组成都会改变,$S$ 的存储开销则随 $N^2$ 增长。不过候选更多倒也不保证监督更准确。两张不同图像可能描述相近内容,两段文本也可能都适合描述同一张图像,此时某些负配对在语义就不一定是负例了。
3.3 构造零样本分类器
预训练结束后,图像向量已经可以与文本向量比较。若下游任务有 $K$ 个候选类别,就把每个类别写成一段文本,编码后得到候选向量 $\mathbf v_k$。给定图像向量 $\mathbf u$,比较相似度:
$$ p(k\mid I)= \frac{\exp(\mathbf u^\top\mathbf v_k/\tau)} {\sum_{j=1}^{K}\exp(\mathbf u^\top\mathbf v_j/\tau)}. $$预测取分数最大的类别。类别描述在这里起到了分类器权重的作用:把文本向量排成矩阵,相似度计算就是图像特征与这组权重的矩乘。§2.5、图 1
训练时,相似度矩阵的一行面对本批次的配对文本;推理时,它面对的是任务的 $K$ 个类别描述。候选的含义变了,但编码、归一化和比较的流程延续下来。固定类别集合后,文本向量还可以预先计算并保存,每张新图像只需要编码一次。这也是两个编码器独立工作的一个直接用途。
提示词也属于分类器的构造过程。直接输入 cat,与输入 a photo of a cat,得到的文本向量可能不同,因此这里也用到了一些 prompt engineering 的技巧。
原论文讨论了提示模板和多模板集成。官方示例先对同一类别在不同模板下的文本向量分别归一化,再取平均并重新归一化,形成一个类别向量。这样,每个类别最终仍对应一组固定权重,就不用在这一步再训练一个新分类头。§2.5、提示模板示例
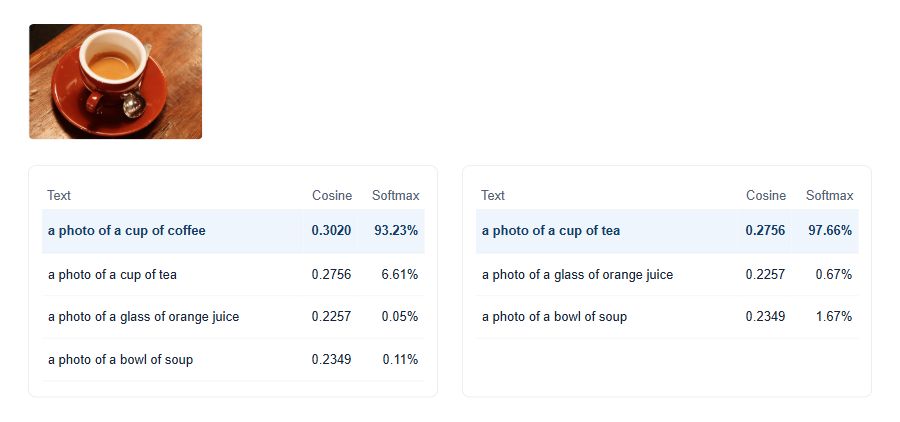
可以看到概率式分母依赖当前候选集合,所以 softmax 分数是在这些候选之间的相对分配。
3.4 主要实验结果
CLIP 的实验覆盖了超过 30 个视觉数据集,涉及一般分类、细粒度识别、OCR、动作识别和地理位置识别等任务。除了验证能否用文本进行分类,论文还比较了少样本迁移、冻结特征的质量,以及分布变化或偏移后的表现。
跨任务的零样本迁移。 最佳模型 ViT-L/14@336px 在 ImageNet 上达到 $76.2\%$ 的零样本 top-1 准确率;在 27 个数据集的比较中,CLIP 在 16 个数据集上超过了用目标标签训练、基于 ResNet-50 特征的线性分类器。表 1、图 4
提示模板与多模板集成。 在 ImageNet 上,相比直接输入类别名,默认照片描述模板带来约 1.3 个百分点的提升;在此基础上集成 80 个模板,再提升约 3.5 个百分点。§3.1.4
零样本与少样本的比较。 在 20 个数据集的平均结果上,零样本 CLIP 与在同一 CLIP 特征空间中、每类用 4 个标注样本训练的逻辑回归分类器表现相当。一种解释是,少量图像样本未必能清楚区分希望学习的东西是什么。图 5
模型扩展。 论文冻结图像编码器,再用目标任务标签训练线性分类器,并在 12 个和更广的 27 个数据集上比较。最大 CLIP 模型的平均表现超过了当时表现很好的 Noisy Student EfficientNet-L2;CLIP 内部的 ViT 版本也表现出较好的计算效率。出§3.3、图 6
自然分布偏移下的鲁棒性。 在 ImageNetV2、ImageNet-Sketch、ObjectNet 等七个分布偏移测试集上,论文以 ImageNet 准确率相近的模型作对照,发现零样本 CLIP 在分布变化后通常保留了更好的表现。§3.4、图 7
CLIP 最引人瞩目的就是其惊人的实验结果。这些实验分别支撑了 CLIP 在直接迁移、视觉表征和分布外泛化等各个方面的强大能力。 其实我也是通过这篇论文才了解到这些具体的多模态领域的经典任务。
3.5 不足
表征对齐不意味着模型获得了完整的视觉推理能力。官方论文与模型说明仍报告了计数、部分细粒度识别等任务上的不足。Limitations、模型说明
从训练目标看,它直接优化的是图文配对的可区分性。若文本没有描述图像中的某个属性,目标也不会单独要求模型精确保留那个属性。比如一段只写“桌上有水果”的文本,不会直接监督每种水果的数量或彼此之间的空间关系。所以对一些,除了分类和分割之外的,可能更复杂的任务,CLIP 还有很多改进的空间。
4. CLIP 的简单试用
CLIP 的官方仓库提供了预训练权重和推理代码,也可以在浏览器中用 Colab 笔记本。这里使用官方 ViT-B/32 模型,在本地 CPU 上做了一组简单的图文配对试用。图像按官方流程缩放、中心裁剪并归一化,输入分辨率为 $224\times224$ 。
简单来说,把 Torch 等依赖,和 CLIP 自己的包安装好后,把 ViT-B/32 权重下载下来,然后 clip.load() ,最后 eval 即可。 我就直接从 scikit-image 示例数据中随便找了点图片,然后预处理,喂给模型。
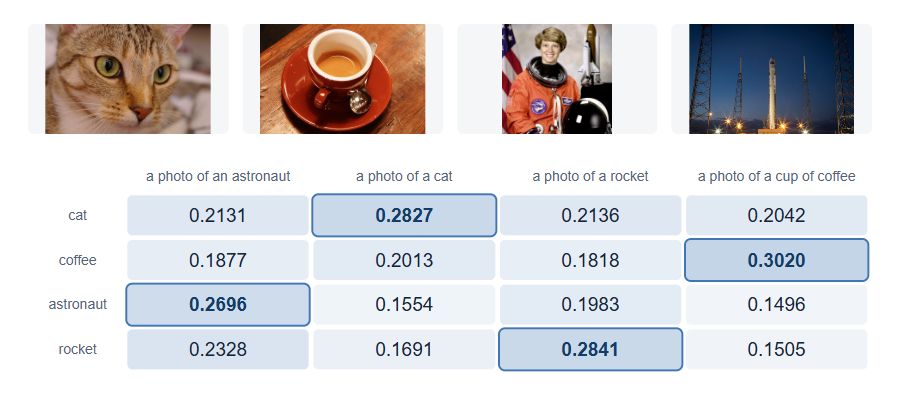
首先比较几种明显不同的内容。 选取猫、咖啡、宇航员和火箭四张示例图,分别与四段描述计算余弦相似度。下图图片从左到右按上述顺序排列,矩阵每一行的边框标出最高分,数值是余弦相似度,不是概率。四张图都找到了对应的描述。这里也能直接看到前文相似度矩阵的用途:编码一次,就可以比较所有图文组合。
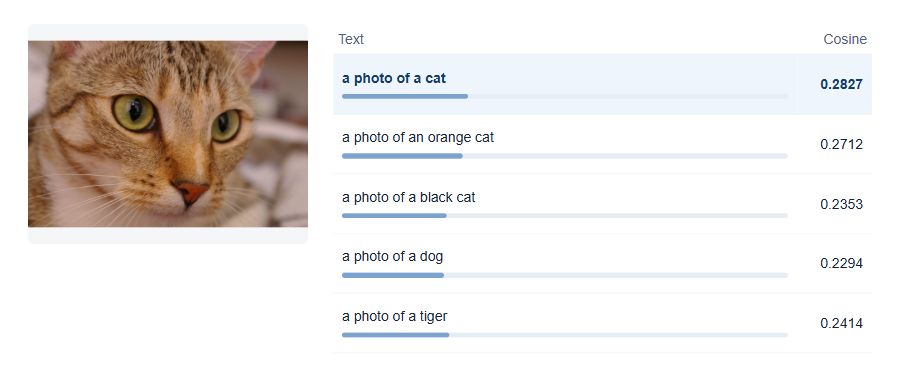
再比较相近的描述。 对同一张猫的照片,加入颜色属性和相似动物作为候选。a photo of a cat 的相似度为 0.2827,a photo of an orange cat 为 0.2712,均高于狗和老虎。
最后改变候选集合。 对咖啡图比较咖啡、茶、橙汁和汤,使用模型学到的缩放系数(约为 100)将余弦相似度转成 logits,再计算 softmax。下图左侧保留咖啡候选,右侧删去这一项。包含咖啡时,咖啡的相对分数为 $93.23\%$,茶为 $6.61\%$;删去咖啡后,茶升至 $97.66\%$,但它的余弦相似度始终是 0.2756。
参考文献
- He, K., Zhang, X., Ren, S., & Sun, J. Deep Residual Learning for Image Recognition. CVPR 2016. 论文
- Dosovitskiy, A., et al. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021. 论文
- Radford, A., et al. Learning Transferable Visual Models From Natural Language Supervision. ICML 2021, PMLR 139. 论文